В первой статье серии я рассказывал, зачем вообще взялся за весь путь целиком — от словаря до голосового ассистента — и почему речь оказалась самой срочной его частью. Там же я обещал рассказать подробнее про распознавание. Вот этот рассказ.
Распознавание речи — это когда компьютер слушает и записывает услышанное текстом. По-английски ASR. Для нашего пути это уши: без них старые записи остаются просто звуком, которого нет в текстовом виде; без них ассистент не поймёт, что ему сказали; без них не из чего делать пары «звук — текст», на которых учится синтез голоса. Всё остальное можно отложить. Уши откладывать нельзя.
И начинается эта история с довольно унизительной цифры.
Что значит «модель почти не знает наш язык»
У меня уже была модель, которая умеет распознавать крымскотатарский — точнее, считалось, что умеет. Большая распознавалка Whisper, доученная на нашем языке. Мы ею даже пользовались — понемногу и только на чистых, качественных записях, где она выглядела прилично. Но честного экзамена с цифрой я ей ни разу не устраивал: читал расшифровки, кивал — вроде понятно.
Первое, что я сделал в этом этапе, — не стал ничего улучшать. Я устроил ей экзамен.
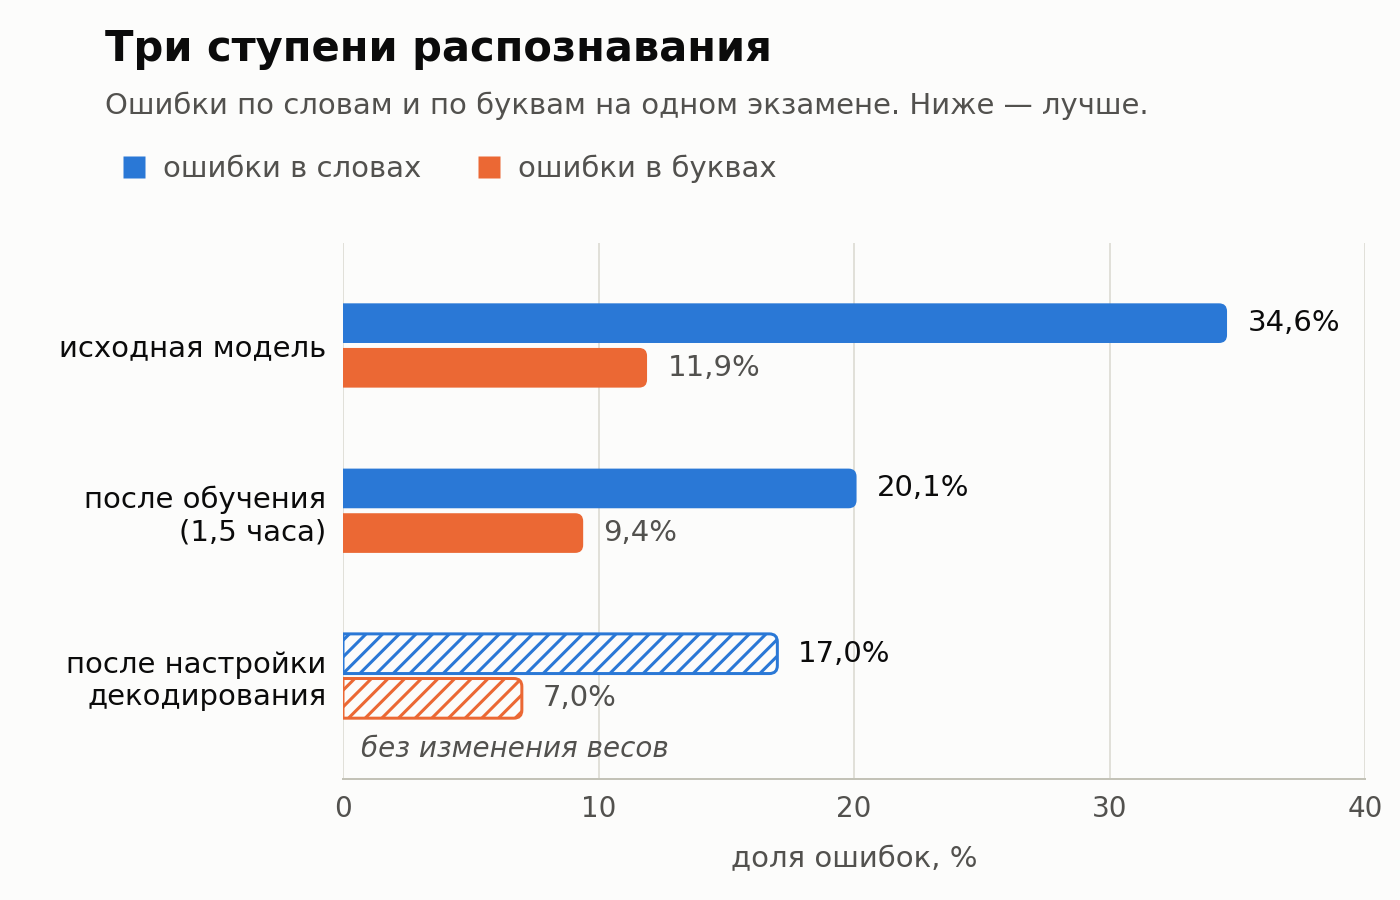
Качество распознавания меряют долей неправильных слов — сколько слов пришлось бы вставить, убрать или заменить, чтобы получить правильный текст. Получилось 34.6 % ошибок по словам и 11.9 % по буквам.
Тридцать четыре с половиной процента — это каждое третье слово мимо. Не «есть шероховатости». Расшифровка, в которой каждое третье слово неверно, не годится ни для поиска по архиву, ни для обучения синтеза, ни тем более для разговора с ассистентом. Человек такое читает как шифровку.
Для сравнения я прогнал на том же экзамене вторую доступную открытую модель для нашего языка, другой архитектуры. У неё вышло 82.3 % по словам и 23.2 % по буквам. Правда, её большая цифра обманчива: она часто теряет границы между словами и склеивает их в одно длинное (düntursamamadıf…) — почти половина её расшифровок короче правильной по числу слов, так что сравнивать честно надо по буквам. По буквам она всё равно проигрывает примерно вдвое.
Так что стартовая точка была ясна: лучшее, что есть у крымскотатарского языка, ошибается в каждом третьем слове.
Отдельно скажу о том, что цифра 34.6 % даже чуть занижает модель: она пишет числа цифрами — 1954, — а в книге они прописью, Biñ doquz yüz elli dört, и программа считает это четырьмя ошибками подряд. Мелочь, но честнее сказать.
Сначала экзамен, потом учёба
Почему я начал с проверки, а не с обучения — это, наверное, главный урок всего этапа.
Проверять модель надо на том, чего она не слышала. Обычно материал делят случайно: девять кусочков в учёбу, десятый на проверку. Для нашего случая это было бы бессмысленно. Соседние кусочки вырезаны из одной и той же записи, читает их один и тот же человек, записаны они в один и тот же день одним микрофоном. Мало того, программа-резчик регулярно рубит одно предложение на два соседних куска — и при случайном делении половина фразы уходит в учёбу, а вторая половина в экзамен. Модель тогда «узнаёт» не язык, а голос и комнату.
Поэтому я отложил на экзамен две книги целиком, с двумя чтецами, которых модель не слышала вообще: 893 кусочка, 1 час 52 минуты. Одним движением из-под модели уходит и голос, и микрофон, и эпоха, и словарь конкретного текста.
Это звучит как очевидная предосторожность. Дальше выяснилось, что её недостаточно.
Четыре книги, которые лежали дважды
Материал у меня копился годами и складывался разными способами в разное время. И вот, прежде чем что-то запускать, я решил проверить банальную вещь: точно ли то, что я отложил на экзамен, не попало заодно и в учебный набор.
По именам файлов — не попало. Совпадений ноль, ни одного пересечения, наборы имён вообще из разных вселенных.
Тогда я сравнил не имена, а сами тексты: искал, нет ли в учебном наборе кусочков, где идут подряд те же шесть слов, что в экзаменационном.
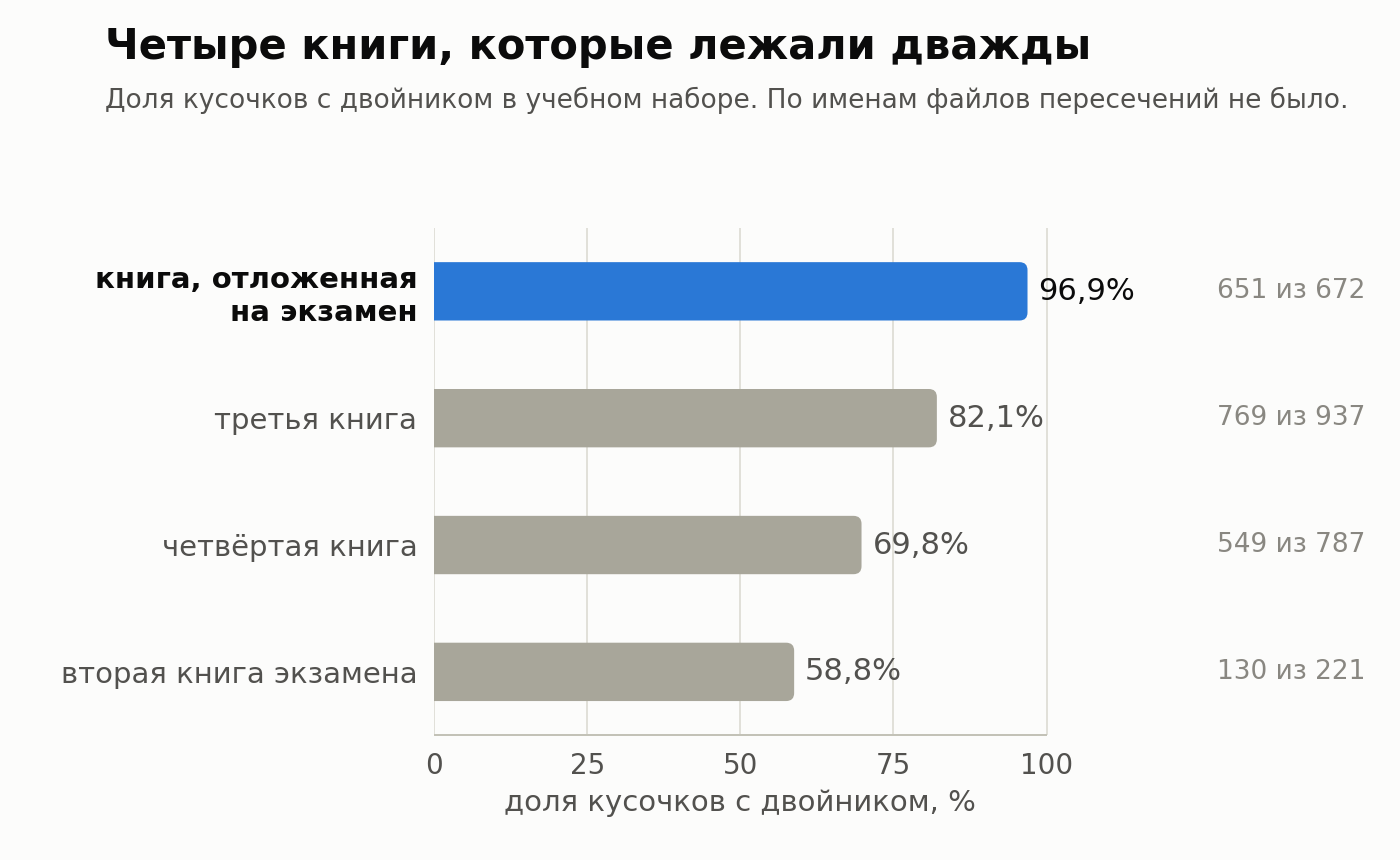
Четыре аудиокниги лежали у меня дважды. Одни и те же записи, нарезанные двумя разными программами в разное время, под совершенно не связанными друг с другом именами.
| книга | сколько её кусочков имело двойника в учебном наборе |
|---|---|
| книга, отложенная на экзамен | 96.9 % (651 из 672) |
| вторая книга экзамена | 58.8 % (130 из 221) |
| третья книга | 82.1 % (769 из 937) |
| четвёртая книга | 69.8 % (549 из 787) |
Верхняя строка — это та самая книга, на которой я собирался проверять модель.
Страха или злости в тот момент не было. Было простое понимание: всем прежним замерам верить нельзя, придётся вычищать материал и мерить всё заново. И одна утешительная мысль поверх: как же хорошо, что это нашлось до обучения, а не после.
Если бы я этого не заметил, дальше всё пошло бы гладко и приятно. Модель училась бы на записях, которые ей потом покажут на экзамене — другой нарезкой, но те же предложения, те же голоса. Она показала бы прекрасную цифру. Я бы обрадовался, написал бы о ней, может быть, выложил бы модель. И цифра не значила бы ровно ничего: это экзамен по билетам, которые заранее раздали.
Самое неприятное в этой ловушке — что у неё нет симптомов. Всё работает. Ничего не падает. Результат даже лучше ожидаемого — и именно это должно настораживать.
Вывод, который я потом вынес отдельно и опубликовал как часть открытого протокола проверки: в языке, где материала мало, повторно нарезанные копии одних и тех же записей — это не исключение, а норма. Материала мало, поэтому к нему возвращаются снова и снова, разными инструментами, и каждый раз получается новый набор файлов со старым содержимым. Искать такие копии надо по тексту, а не по именам.
После чистки учебный набор был перепроверён заново: ни одного кусочка из экзамена, ни одного кусочка из запрещённых семей имён, ни одного совпадения по шести подряд идущим словам. Не «я уверен, что почистил» — а измерено и записано.
Полтора часа обучения
А теперь та часть, которую все считают главной и которая на самом деле оказалась самой быстрой и самой скучной.
Переучивать модель целиком не нужно. Есть приём: основную модель не трогают вообще, а рядом с ней дописывают маленький «довесок» — несколько дополнительных слоёв, которые подправляют её поведение. Учится только довесок. В моём случае он составил 2 % от всех параметров модели: тридцать один миллион обучаемых против полутора миллиардов замороженных.
Учебного материала было 15 с половиной часов речи — то, что осталось после всех чисток. Три прохода по нему, 705 шагов.
Полтора часа на одной домашней видеокарте. Пик потребления видеопамяти — 10.4 гигабайта, то есть это помещается в обычную игровую карту, а не в серверную стойку. Готовый довесок весит 126 мегабайт. Его можно переслать в мессенджере.
Результат на экзамене: 20.1 % ошибок по словам вместо 34.6 %, и 9.4 % по буквам вместо 11.9 %. Ошибок в словах стало на 42 % меньше.
Скажу честно: сразу после обучения особого восторга не было — цифра как цифра, стало лучше, так и задумывалось. Распирать гордость меня начало позже, когда я пропустил через модель то, на чём она вообще не обязана была работать: фильмы, подкасты, шумные записи — и расшифровки читались почти идеально. Вот тогда стало понятно, что это не строчка в таблице, а рабочие уши.
Улучшились обе экзаменационные книги, причём меньшая и более поздняя — та, где другой чтец, — улучшилась даже сильнее. Это важная деталь: значит, модель не заучила манеру одного конкретного человека, а действительно стала лучше слышать язык.
И два наблюдения по дороге, которые мне кажутся полезнее самой цифры.
Первое: на первой контрольной точке модель была хуже, чем до обучения. Я сохранял промежуточные состояния через каждые сто шагов и проверял каждое. Сотый шаг оказался заметно хуже исходной модели — довесок к этому моменту наполовину выучил новое поведение и уже мешает старому, но ещё ничего не даёт взамен. Если бы я посмотрел на первую контрольную точку и решил, что затея провальная, я бы всё выключил и был бы неправ.
Второе: начиная примерно с двухсотого шага цифры перестали двигаться. Вся польза была получена внутри первого прохода по материалу, а следующие два не добавили ничего. То есть полтора часа — это ещё и с запасом; можно было управиться за полчаса.
А потом ошибок стало ещё меньше — без всякого обучения
Дальше самое интересное, и это половина всей истории.
У готовой модели есть не только то, что она знает, но и то, как она выбирает слова, когда отвечает. По умолчанию она идёт самым простым путём: на каждом шаге берёт слово, которое кажется ей наиболее вероятным прямо сейчас, и никогда не оглядывается назад. Быстро — и иногда катастрофично: свернув не туда, модель уже не может исправиться и начинает ходить по кругу.
Именно это и было в худших кусочках экзамена. Не «не расслышала» — а зациклилась:
Qıznıñ qıznıñ qıznıñ qıznıñ …
– dedi Akimoviç, – dedi Akimoviç, – dedi Akimoviç, …
Альтернатива — заставить модель держать в голове несколько вариантов фразы сразу и выбирать лучший целиком, а не по одному слову. Это дороже по времени, но не требует ни грамма переобучения.
Я перебрал 24 разных настройки — но не на экзаменационном материале, а на отдельном маленьком наборе, отложенном специально для выбора (о нём ниже). Победитель поехал на экзамен, один раз.
17.0 % ошибок по словам и 7.0 % по буквам. Ни один вес модели при этом не изменился. Изменилось только то, как аккуратно она подбирает слова, — и это стоило 3.1 раза больше времени на расшифровку.
Честный разбор: откуда взялся этот выигрыш
Тут легко было остановиться и написать «настройка декодирования даёт минус 15 % ошибок». Это правда, и это же полуправда. Я разобрал выигрыш по кусочкам, и картина оказалась поучительнее итога.
Всего на экзамене было отыграно 409 ошибочных слов. Из них 160 пришлись на три кусочка из 893.
Три штуки. 0.34 % материала дали 39 % всего выигрыша. Это те самые зацикленные кусочки: на 41 слово правильного текста модель выдала 175 слов ошибок, повторяя одно и то же. Оставшиеся 890 кусочков улучшились на скромные 10 % — ровно и без фокусов.
Обе половины настоящие, и ни одна из них сама по себе не оправдала бы трёхкратного замедления. Но выводы из них разные. Широкие 10 % — это «модель стала аккуратнее». А три кусочка — это «перестала иногда сходить с ума». Для расшифровки архива второе важнее первого: кусочек, где вместо предложения записано пятьсот байт одного повторённого слова, не просто плохой — он отравляет всё, что на нём потом будут учить.
Кстати, после настройки таких кусочков не стало вообще. Ноль из 893.
Настройка, которая должна была помочь, а сделала хуже
Среди настроек есть и прямолинейная: запретить модели повторять одно и то же дважды. Выглядит как ровно то, что нужно против зацикливания.
Я её проверил — и она оказалась вредной. Из 255 проверочных кусочков она сломала 17 и починила один. Причём 12 из 17 сломанных до этого были практически безупречными.
Причина видна в самих расшифровках. Запрет не мешает модели повторяться — он заставляет её повторяться неправильно:
в книге     – Qartbaba, qartbaba, – tez-tez çapıp kelgen kiçkene Aziz
без запрета – Qartbaba! Qartbaba! – tez-tez çapıp kelgen kiçkene Aziz
с запретом  – Qartbaba! Qartbabaa! – tez-tez çapıp kelgen kiçkene Aziz
и жёстче    – Qartbaba! Qartbava! – tez-tez çapıp kelgen kiçkene Aziz
Ребёнок бежит и зовёт: «Къартбаба, къартбаба!» Модель услышала это совершенно правильно. А запрет на повтор не дал ей записать то, что она услышала, — и она исказила второе слово, лишь бы оно не совпало с первым. В другом месте так же пострадало bağışla… bağışla… — «прости… прости…» — превратившись во второй раз в несуществующее Bağuşla. В третьем модель обошла запрет, вставив выдуманное окончание: parçalarnıñ parça вместо parçalar.
Двойное обращение и двойная просьба — это обычный крымскотатарский. Так говорят. Запрет не умеет отличить живой повтор от машинного зацикливания, а в нашем языке живых повторов много.
Мне эта история нравится больше всех остальных в этом этапе, потому что она не про технику. Язык нельзя чинить запретами. Любое правило вида «так не бывает» рано или поздно наткнётся на то, как люди на самом деле говорят, — и сломает именно это место, оставив всё остальное в порядке, чтобы вы ничего не заметили.
Дисциплина, без которой все цифры выше были бы враньём
Выше я пару раз вскользь упоминал «отдельный маленький набор» и то, что экзамен прогонялся считаные разы. Пора объяснить, как это устроено, — потому что на этом держатся все цифры статьи.
Наборов не два, а три.
Учебный — на нём модель учится.
Отборочный — 255 кусочков, полчаса звука, две короткие вещи целиком, вынутые из учебного материала и в обучении не участвовавшие. Он нужен, чтобы выбирать: какое из сохранённых состояний модели лучше, какая из 24 настроек лучше. По нему я гонял десятки замеров сколько угодно раз.
Экзаменационный — те самые две книги. По нему я прогнал модель ровно два раза за весь этап: один раз на победившем состоянии после обучения, один раз на победившей настройке. Правило, по которому выбирается победитель, я формулировал заранее, до того как смотрел на результаты.
Зачем такая строгость? Потому что если гонять экзамен многократно и каждый раз брать лучший результат, то выбирается уже не лучшая модель, а самая удачливая. Цифра при этом получается красивая и не воспроизводится больше никогда.
И отборочный набор тоже пришлось проверить на чистоту — ноль общих кусочков и ноль совпадений по шести словам подряд с учебным материалом. После истории с двойниками я это больше не считаю паранойей.
Заодно отборочный набор преподал мне ещё один урок. Он оказался сильно легче экзаменационного: одна и та же модель на нём ошибалась в 17 % слов, а на экзамене — в 34.6 %. Обе выборки честно отложены, обе модель не слышала. Но отборочные вещи — из того же круга материалов, что и учёба, а экзаменационные книги — два совершенно чужих чтеца. Значит, отборочный набор годится, чтобы сказать «эта настройка лучше той», и совершенно не годится, чтобы сказать «модель ошибается настолько-то».
Один раз это меня и подвело. Есть у Whisper встроенный сторож против зацикливания — он умеет замечать, что текст пошёл по кругу, и переспрашивать себя. Это ровно тот инструмент, который нужен, и он почти ничего не стоит по времени. Но на отборочном наборе не было ни одного зацикливания — не на чем было его проверить, и он там выглядел как настройка, которая вообще ничего не делает. Выбрать его по своим же правилам я не мог. Честный ход тут один: записать, что инструмент не проверен, и не подсовывать его на экзамен задним числом, пока не появится подходящий материал. Так что цифры для него у меня нет, и я её не выдумываю.
В студии 17 %. А в жизни?
Всё, что я описал, измерено на одном и том же типе звука: один человек, один микрофон, тихая комната, читает книгу. Это честная цифра для своего мира — и она мало что говорит о мире, в котором живёт голосовой ассистент.
Поэтому следующий шаг был такой: взять те же самые 893 экзаменационных кусочка и испортить их семнадцатью способами — добавить шум, музыку, чужие голоса, эхо комнаты, пропустить через телефонную линию, ускорить и замедлить. Текст-то известен, значит, ошибку можно честно померить в каждом из этих миров.
Коротко, что выяснилось.
Телефонная линия и плохое сжатие звука — бесплатны. По телефонной полосе модель работает даже на волос лучше, чем в студии. Скорость речи тоже почти не мешает: ускорь или замедли на 15 % — заплатишь не больше 6 %.
А вот чужие голоса на фоне — главный враг, и с большим отрывом. Гул чужой речи стоит примерно вдвое дороже, чем ровный шум той же громкости, и вчетверо дороже музыки. Когда чужая речь звучит так же громко, как нужная, ошибок становится 69 % вместо 17 — модель перестаёт работать. Второй враг — эхо: в гулком помещении вроде коридора или большой комнаты ошибки вырастают в два с половиной раза.
Из этого следует довольно конкретная вещь для будущего ассистента: главное вложение в надёжность — не «ещё данных», а умение выделить нужный голос из нескольких и правильно поставленный микрофон.
И ещё одна проверка, которая меня порадовала. Я взял открытый набор крымскотатарских аудиокниг, на котором никогда не учился, и прогнал модель по нему. На чистых главах она показала практически ту же цифру, что и на моём экзамене. Значит, она не заучила моих чтецов — она действительно слышит язык.
Так что 17 % — это не «готово», это опорная точка. Дальше начинается работа с настоящим шумом, и она уже идёт.
Это вторая статья серии. Дальше расскажу, как синтезированный голос прочитал целую книгу — шестнадцать глав, почти два часа звучания — и что пришлось проверять в каждой главе отдельно. А потом — про то, как я арендовал чужие видеокарты в облаке и честно сжёг на них деньги, почти ничего не посчитав.
Аудиопримеры и другие материалы — https://ai.ana-yurt.dev/ru/blog/2026-09-mashina-nauchilas-slyshat/.
Хотите помочь? Больше всего проекту нужны носители языка. Послушать кусочек записи и сказать, правильно ли машина его записала; прочитать расшифровку и поправить; подсказать, где слово звучит не по-нашему. Программировать для этого не нужно — достаточно хорошо слышать родной язык. Как раз такие уши в этом этапе нашли то, чего не нашла ни одна проверка. Пишите: support@ay.mw.
А если хотите поддержать работу материально — это можно сделать здесь: ko-fi.com/anayurt. Эта поддержка превращается в новые записи живой речи — а записывать её важно сейчас, пока есть у кого учиться.