В первой статье серии я одной таблицей рассказал, что синтезированный голос прочитал целую книгу: роман Шамиля Алядина «Merdiven» («Лестница»), шестнадцать глав, 1 час 58 минут звучания. Во второй пообещал рассказать, что стоит за этой таблицей. Вот этот рассказ.
Синтез речи (по-английски TTS) — это когда компьютер читает текст вслух. Для нашего пути это голос. Без него не будет аудиокниг, не будет читалки, которая произносит текст, а ассистент сможет только молча печатать ответы.
Почему не фразы, а книга
Показать синтез на нескольких фразах легко. Берёшь удачные, ставишь на страницу, и всё звучит. У меня тоже так было: четырнадцать проверочных фраз, нарочно набитых самыми трудными для нашего языка звуками — къ, гъ, нъ, дж. По ним я сравнивал одну версию модели с другой.
Но четырнадцать фраз ничего не говорят о том, как голос ведёт себя десять минут подряд. Не уплывает ли тембр к концу главы. Что машина делает с диалогами, с именами, с числами, с репликами в одно-два слова. Как она дышит. В отрывке на пятнадцать секунд этого не слышно. В книге слышно всё.
Поэтому следующим шагом стала одна глава целиком — первая глава «Merdiven», 1 608 слов, около двенадцати минут. Задача была не «послушать, как красиво», а найти, что ломается. Сначала я убедился, что этого текста не было среди материалов, на которых училась модель: ни одного совпадения по шести словам подряд против почти 1.4 миллиона слов. Иначе машина не читала бы, а вспоминала. Позже ту же проверку прошла вся книга, тоже с нулём совпадений.
Почему именно «Merdiven»? Я очень люблю Шамиля Алядина, и мне хотелось, чтобы первой книгой, которую прочитает машина, стало одно из его произведений. К тому же роман подходил по стилю: ровная повествовательная проза. Юмористические рассказы или детские книги, где нужна игра голосом, модель тогда читать ещё не была готова.
Первая же цифра оказалась уроком. На проверочных фразах машина ошибалась примерно в 14 % букв (если прочитать синтез обратно нашей распознавалкой и сравнить с текстом). На обычной прозе главы — меньше чем в 2 %. Модель за ночь лучше не стала. Просто проверочные фразы были нарочно злыми, а обычный текст — нет. Цифру с проверочного набора с тех пор я не выдаю за то, как модель читает на самом деле.
А общий вердикт по главе получился неожиданным. Голос держался: тембр от первой минуты до последней почти не менялся, темп был ровным. Ошибки нашлись не в самой модели, а в подготовке текста и звука вокруг неё: в том, как текст режется на предложения, как склеиваются короткие фразы, как обрезаются вдохи. Эту часть я писал сам, и это была хорошая новость: её можно исправить, не переобучая модель.
На чём держится этот голос
Коротко напомню то, что подробно было в первой статье. Готовые модели от соседних языков читают наш къ как обычное к, а qara превращается в «кара». Поэтому основу для голоса я выбирал по одному признаку: чтобы она уже умела произносить этот звук. Нашлась многоязычная модель, которая много слышала казахский, уйгурский и башкирский. Крымскотатарского в ней не было, и я обошёл это хитростью с письмом: наши къ, гъ, нъ переписываются в башкирские буквы ҡ, ғ, ң, которые модель знает, и дальше она читает наш текст как башкирский.
Голос при этом берётся отдельно. Модель, которую я дообучал, учится языку, а не тембру. Тембр она берёт из короткого образца, нескольких секунд чьей-то записи с точным текстом. «Merdiven» прочитан голосом Sevil, и каждое предложение книги озвучено по одному и тому же семисекундному образцу.
У хитрости с буквами было и четвёртое правило, и о нём стоит сказать отдельно.
Одна буква, разницу в которой видно только на длинном тексте
В первой статье я рассказывал про «нидже», которое машина прочитала как «ниже»: правило переписывания заодно превращало дж в ж, и модели буквально подавали русское слово. Здесь важно продолжение.
Чтобы починить, я сравнил пять способов записать этот звук. На четырнадцати проверочных фразах два лучших варианта были неразличимы, оба исправляли слово. Тогда я заново озвучил с каждым из них всю главу, 195 предложений. Один из двух, татарская буква җ, исправлял злополучное «нидже» и при этом портил остальное: ошибок по буквам по всей главе становилось на 27 % больше. Обычное дж исправляло слово и не портило ничего.
На 14 проверочных фразах два варианта выглядели одинаково хорошими, а целая глава из 195 предложений сразу показала, что один из них вредит. Ради таких открытий и стоило дать машине прочитать книгу целиком.
Что сломалось на первой главе
Склейка коротких предложений. Поначалу я склеивал короткие предложения с соседними. Логика казалась железной: модель училась на записях не короче трёх секунд, значит, реплику в два слова лучше не давать ей отдельно. Проверять эту логику я не стал. Зря.
На склеенных кусках модель начала выбрасывать целые предложения:
| что просили прочитать | что прочитано |
|---|---|
| Men yañılğanım. O, oca degil eken. | O, oca degil eken. |
| – Yoq. Siz yañlışasıñız. Meni bir daa iç bir yerde köralmaycaqsıñız. | Meni bir daa iç bir yerde köralmaycaqsıñız. |
«Я ошибся. Он, оказывается, не учитель» превратилось просто в «Он, оказывается, не учитель». Склеенные куски занимали четверть текста главы, а ошибок давали 43 %.
Тогда я наконец проверил само допущение и прочитал главу без склейки. Короткие предложения действительно выходят хуже: ошибок в них примерно в два с половиной раза больше, хотя в абсолютных числах это около двух процентных пунктов. Ошибок становится меньше примерно до семидесяти букв, а дальше почти ничего не меняется. Главное же оказалось в другом: штраф за короткие реплики меньше, чем цена склейки, которая теряла целые куски фраз. Склейку я выключил.
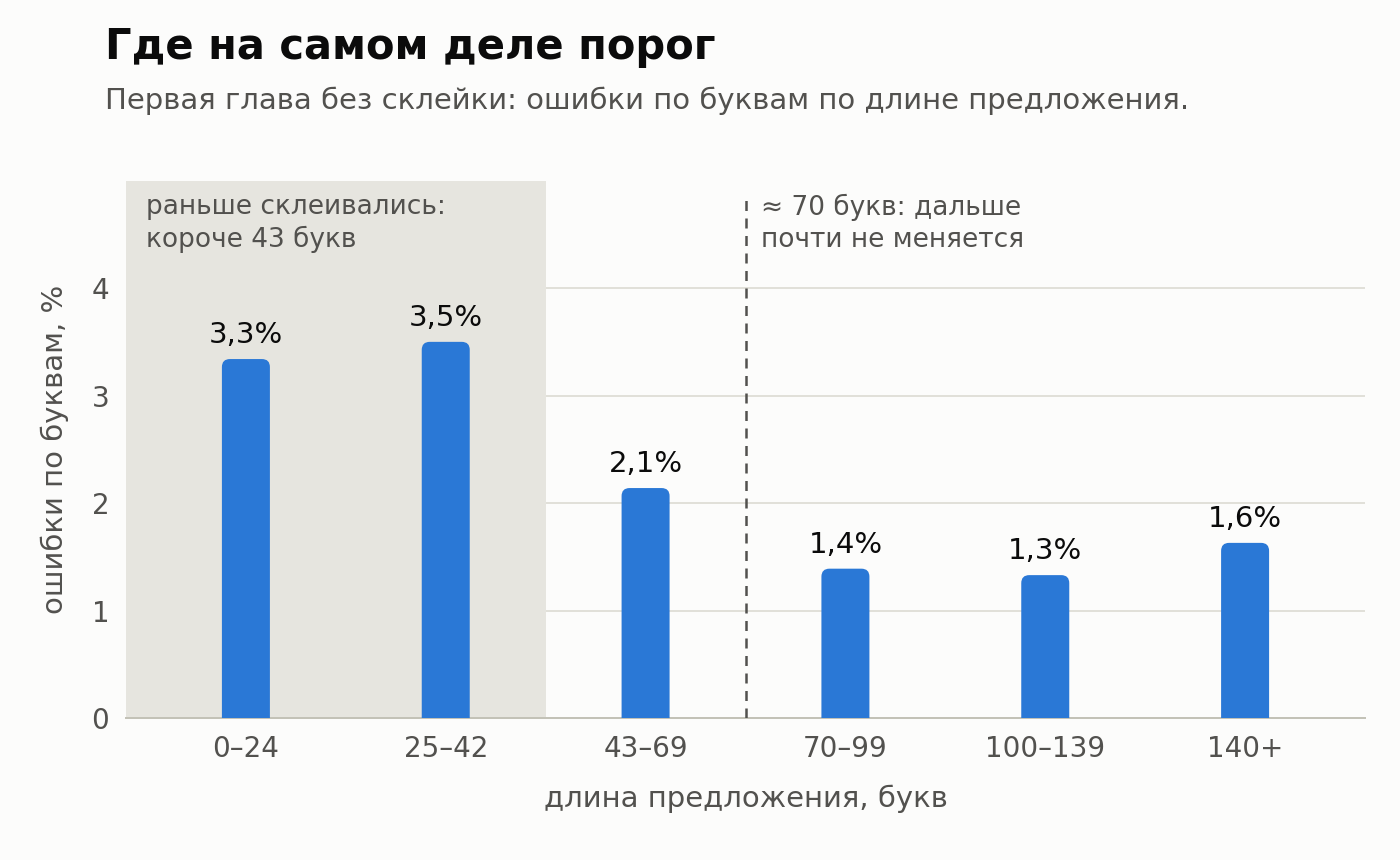
Первая глава, прочитанная без склейки. Раньше к соседям приклеивалось всё, что короче 43 букв, а ошибок становится меньше примерно до семидесяти.
Обрезка, которая ела первое слово. Синтез иногда начинает фразу со вдоха, как живой диктор, и я написал обрезку: всё, что звучит до первого звонкого звука, считается вдохом и срезается. Но первое слово часто начинается с глухого согласного. «Çañ qaqıldı» превращалось в «Qaqıldı», «Tışta, yeşergen…» — в «yeşergen…». В 111 предложениях из 147 обрезка заходила внутрь первого слова. Глава без всякой обрезки читалась лучше, чем с моей «починкой».
Новая обрезка смотрит не на звонкость, а на громкость. Согласный звук тихий, но всё же намного громче паузы перед ним. С новой обрезкой глава читается лучше, чем вообще без неё.
Вдохи, которых было не столько. Первая проверка сообщила, что вдохом начинается 89 % предложений. Цифра пугала. Потом выяснилось, что это обрезка отчитывалась сама о себе: вдохом она считала всё, что было до первого звонкого звука, то есть те же глухие согласные. Честный замер нашёл вдох в начале одного предложения из пяти. Зато основная часть вдохов оказалась не в начале, а между словами — ровно там, куда обрезка вообще не смотрела. Таких предложений было 76 из 195. Эти вдохи я научился приглушать до уровня фона, не сдвигая ни одной отметки времени, и 68 из 76 таких предложений после этого распознаются буква в букву так же, как раньше.
Темп. Машина читает быстрее живого диктора: 17.4 буквы в секунду против 14.5. Глава, которую я ждал на пятнадцать минут, уложилась в двенадцать. Для аудиокниги это звучит немного торопливо. Паузы между фразами я, кстати, не придумывал, а померил у живого диктора на десяти минутах чтения: медиана между предложениями — 288 миллисекунд, и только три паузы за все десять минут длиннее 0.6 секунды. Так появились мои паузы: 300 миллисекунд между предложениями, чуть больше при смене говорящего, ещё чуть больше между абзацами.
После всех починок ошибка по буквам на главе стала 1.84 % вместо 2.56 % в первом варианте. Модель та же самая. Изменилось только то, что я ей подавал, и то, что делал со звуком после.
Шестнадцать глав, каждая сама по себе
Дальше были остальные пятнадцать глав. Первую я заново не озвучивал: она вышла из той же цепочки, а её текст после всех поправок совпал с прежним байт в байт.
Целая книга нашла то, чего не нашла одна глава. Три звёздочки, которыми в книге разделены сцены, уходили модели как текст, и она их честно «читала». Последний абзац романа, авторскую дату «1940 s.», программа приняла за обычный текст, и роман заканчивался произнесённым вслух годом. А пять предложений рвались пополам там, где абзац обрывался на многоточии.
В седьмой главе сработала защита, которую я встроил в сборку: программа отказалась собирать главу, потому что слова одного предложения, склеенные обратно, не давали исходный текст. Причина — двойной пробел в файле книги. Ничего не слышно и ничего не видно на экране. Но читалка, которая показывает текст по словам, молча потеряла бы этот пробел. Это был уже второй раз, когда программа, отказавшаяся работать, нашла то, чего никакое прослушивание не нашло бы. После этого я поменял и порядок работы: если в одной главе сработала защита, остальные главы всё равно идут дальше. Книга, остановившаяся ночью на седьмой главе, — это потерянная ночь.
Каждую главу я проверял отдельно, и одна выглядела плохо: в четвёртой главе ошибка по буквам 8.3 %, вчетверо выше медианы по книге. Я полез слушать, и глава оказалась нормальной. Всю ошибку дала одна реплика из двух слов, «– dep tüşündi.», на которой проверяющая распознавалка зациклилась и записала её двадцать пять раз подряд. Без этой реплики у главы около 2 %, как у всех. Та же реплика подвела проверку и во второй главе, просто там это было не так заметно. Ошиблась не читающая машина, а проверяющая.
Это, кстати, причина, по которой одно среднее число на всю книгу было бы неправильной цифрой. Одна такая реплика портит среднее, ничего не говоря о самом чтении. По главам картина ровная: медиана 2.15 %, лучшая глава 1.5 %, худшая 2.7 %. Ни к концу книги, ни на длинных главах качество не плывёт. Самая длинная, вторая, звучит девятнадцать с половиной минут и читается с ошибкой 2.5 %.
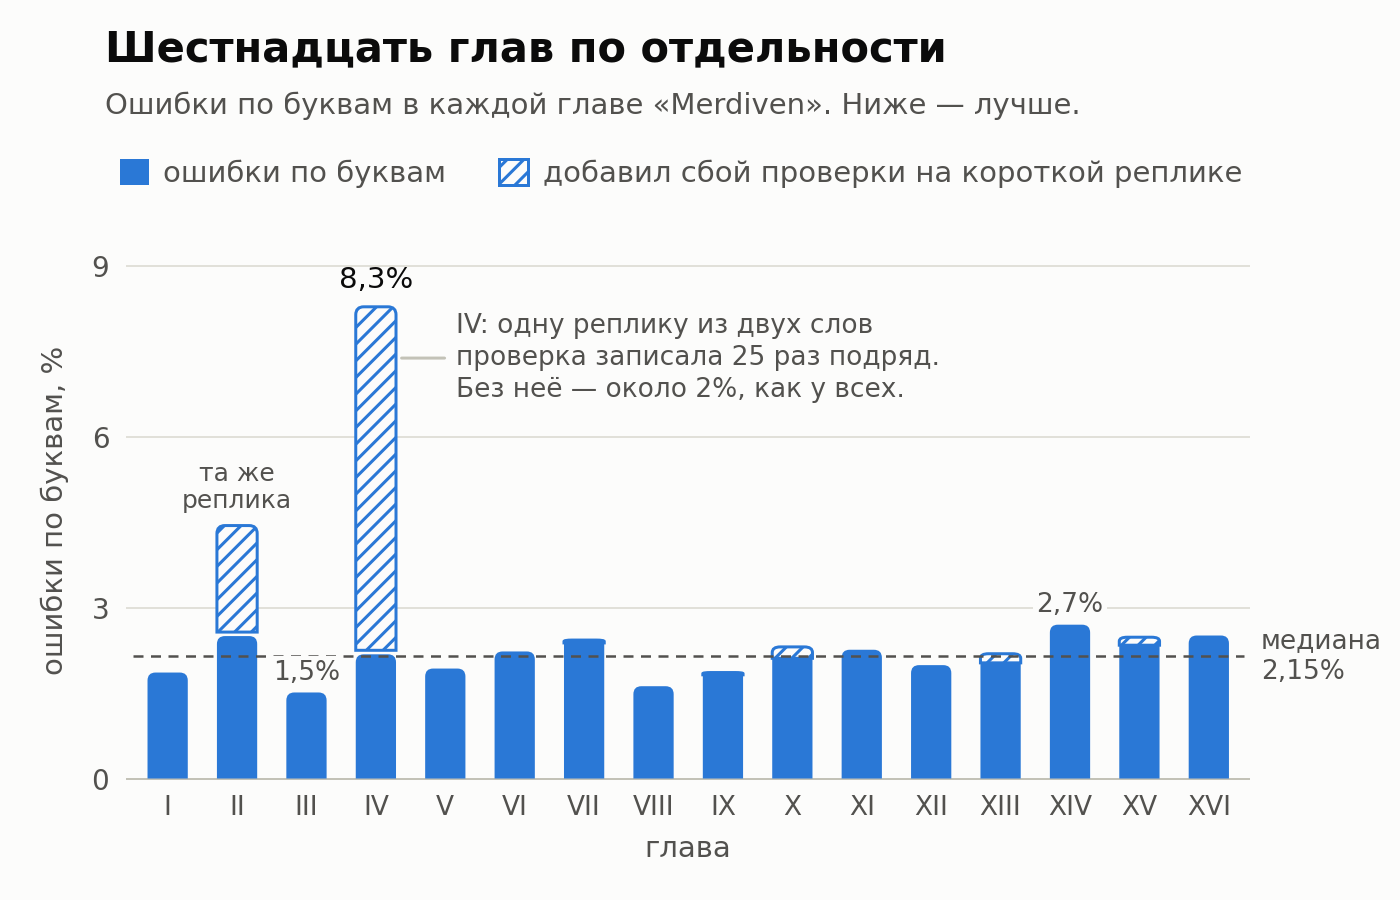
Штриховка — то, что добавили сбои проверки на коротких репликах, а не само чтение. Почти вся она — одна и та же реплика «– dep tüşündi.»: на ней распознавалка зациклилась и в четвёртой главе, и во второй.
Про цену я уже писал в первой статье: на два часа звучания уходит около трёх часов работы домашнего компьютера. Сам синтез — меньше половины этого времени. Больше уходит на то, чтобы привязать каждое слово ко времени и всё проверить. И это того стоит.
Читалка, которая подсвечивает слова
Книга была нужна не просто как звуковой файл. Я хотел читалку: текст на экране, голос читает, текущее слово подсвечивается, щёлкнул по слову — чтение перескочило туда.
Для этого надо знать, когда звучит каждое слово. Тут пригодился тот же приём, с которого начинался весь проект: совмещать звук с заранее известным текстом. Только теперь известный текст — это то, что машина сама получила на вход. Каждое предложение я выравнивал отдельно, по его собственному тексту, а потом переводил в общее время главы. Во всех шестнадцати главах время есть у 100 % слов. Без отметок остались только тире и знаки, которые не произносятся.
Сомнительные отметки при этом не разбросаны случайно. Больше всего их на первом слове после тире в диалоге, и именно там же спотыкается проверка распознаванием. Два разных прибора независимо показывают на одни и те же места. Низкая оценка слова для меня теперь повод послушать предложение, а не удалить отметку.
Про разметку, которая к концу главы разъехалась на 44 секунды, я рассказывал в первой статье. После той истории сборка сравнивает конец последнего предложения с длиной звукового файла и отказывается работать, если они расходятся больше чем на полсекунды. И ещё одна защита родом из истории с «нидже». Первую сборку читалки я сделал на старой озвучке, до исправления дж, и единственным признаком этого было то, что голос говорил «ниже». Теперь каждая глава хранит отпечаток своего звукового файла, и устаревшую озвучку видно по данным, а не только на слух.
Читалка работает на ana-yurt.com: одна страница и для чтения, и для слушания. «Merdiven» можно открыть и прослушать целиком: ana-yurt.com/kutuphane/3444/read.
Чей это голос
Раз тембр берётся из образца, выбор голоса — это выбор нескольких секунд записи. И образец оказался важнее, чем я думал.
Свой голос я сначала пробовал на отдельных фразах и услышал длинные неуместные паузы посреди предложений. Первая мысль была, что виновата модель. Виноват был образец: в нём было 0.77 секунды тишины перед словами и 1.77 секунды после. Модель берёт из образца не только тембр, но и темп, то есть сколько времени тратить на каждую букву, и лишнее время раскладывала паузами внутри фраз. Я обрезал тишину по краям образца, и медиана суммарных пауз внутри предложения упала с 930 до 85 миллисекунд. В слепом сравнении голос с обрезанным образцом было не отличить от прежнего: 7 к 6. Дефект ушёл, голос остался.
Потом голос показался мне глухим. Тут виноватым оказался микрофон: петличка на груди стоит сбоку от рта и теряет как раз те частоты, которых не хватало, а плоская настройка этого не исправляла. Фильтром такое не дорисуешь: чего микрофон не записал, того в записи нет. Пришлось записать образцы заново.
Была и попытка помочь мужскому голосу через обучение: я добавил в учебные материалы больше мужской речи. В слепом сравнении новая версия проиграла прежней со счётом 3 к 11, а один из женских голосов в синтезе от этого сместился ниже по тону, с 208 до 199 герц. Замер тона я включил только после того, как высказалось ухо, и оба показали на один и тот же голос. Эту версию я не оставил.
Когда с паузами и микрофоном разобрался, я решил попробовать для целой книги свой собственный голос. Так вторую книгу в нашей библиотеке — Юнус Къандым, «Куреш мейданыны от басмаз», 28 глав, 6 часов 29 минут звучания — машина прочитала моим голосом. Её тоже можно послушать: ana-yurt.com/kutuphane/3516/read. Читала её уже нынешняя версия модели, а «Merdiven» — более ранняя.
Эту книгу я тоже выбрал не случайно. Её автор, Юнус Къандым, — мой дядя, и мне очень хотелось, чтобы его книга прозвучала именно моим голосом.
Обычно, когда слышишь свой голос в записи, он кажется чужим и странным. Здесь всё было иначе. Когда я услышал первое предложение в своей озвучке, моему счастью не было границ: качество оказалось очень хорошим.
Что пока не получилось
Ударение. Эта история шла по кругу, и она мне дороже остальных. Я заметил, что имя «Риза» машина иногда читает как «Рыза». Проверка подтвердила: примерно в половине предложений так и есть, и с «Азизом» то же самое. Нашлась и починка: писать на входе «ий» вместо «и». Задняя гласная после этого исчезала полностью, а ошибок в самом имени становилось меньше. Приборы были довольны.
Я послушал вслепую и не принял. В заметке к слепой странице написал: «если слышу И, то ударение неверное». Починка возвращала правильную гласную и при этом утаскивала ударение на первый слог, а у нас оно на последнем. Обе версии были неправильными, каждая по-своему.
Сильно я не расстроился. Это первые модели, и такие ошибки я в них допускаю. Я решил вернуться к этой проблеме позже.
Тогда я стал мерить само ударение. В нашем языке последний слог слова обычно немного тянется, причём у живых дикторов одни слова тянутся сильно, а другие почти никак. В среднем модель тянет последний слог столько же, сколько люди. Но воспроизводит она только около шести десятых этого размаха: недотягивает как раз те слова, которые дикторы тянут сильнее всего, и перетягивает плоские. Я по очереди проверил, откуда это берётся. Образец голоса меняет только общий темп. В учебных записях люди тянут эти слова как положено, то есть учиться модели было у кого. Настройки, с которыми модель читает, ничего не меняют. А у исходной модели, до моего дообучения, та же самая ровность. Следующий подозреваемый — то, как модель заранее отмеряет длину всей фразы. Если длина задана наперёд, удлинить последний слог можно только за счёт соседних. Пока это гипотеза, и проверять её — уже работа с самой моделью, а не с текстом на входе.
Вдохи. Чистка вдохов ни разу ничего не ухудшила, но короткие вдохи, в десятую долю секунды, частично остаются. Больше всего их у моего голоса: в одном из замеров вдохи занимали 15 % звучания, у Sevil — около 1 %. Обрезка тишины в образце сократила это больше чем вдвое, но не до нуля.
Паузы на эмоциональных репликах. Мне казалось, что там, где текст эмоциональнее, машина делает паузы длиннее. Я проверил это на предложениях, подобранных так, чтобы спокойные и эмоциональные не отличались ни длиной, ни числом запятых, и связи не нашёл. Паузы зависят от длины предложения и количества запятых, а эмоциональные фразы в прозе просто чаще длиннее. Но померить я смог только общую длину пауз, а не то, где именно они стоят. Пауза не на месте в восклицании режет слух сильнее, чем та же пауза у запятой, так что для меня вопрос не закрыт.
Диалоги. Тире перед репликой модель видит, но смену говорящего читает как новое предложение, а не как новый голос.
Числа. Их я заранее превращаю в слова, но проверить их прочтение распознаванием нельзя: оно записывает услышанное цифрами, и «1924» превращается в «19124». Числа пока проверяет только ухо.
Что я вынес из этой книги
Голос оказался самой надёжной частью всей цепочки. Почти всё, что ломалось, было не в модели, а в подготовке текста и звука вокруг неё: склейка, обрезка, буквы, разметка, двойной пробел. Часть этого нашли приборы, и ухо не нашло бы её никогда. Часть нашло ухо, и прибор не умел её даже оценить: «нидже», ударение в «Ризе», вдохи между словами. А книга целиком нашла то, чего не нашли бы ни 14 фраз, ни одна глава.
Когда я дослушал книгу до конца, я почувствовал гордость: проделанная работа была не впустую и дала отличный результат. Но это не повод расслабляться. В книге всё ещё слышны места, которые нужно доработать, а значит, работы у нас ещё много.
Это третья статья серии. Дальше расскажу подробнее, как я выбирал основу для голоса, которая уже умеет произносить наш къ, и почему соседний турецкий для этого не годится. А потом, как и обещал, про облачные видеокарты.
Аудиопримеры к статье — https://ai.ana-yurt.dev/.
Хотите помочь? Больше всего проекту нужны носители языка. Послушать главу и отметить, где ударение не на своём месте, где имя прочитано не так, где пауза разрывает фразу. Программировать для этого не нужно — достаточно хорошо слышать родной язык. В этой книге самые важные находки сделало именно ухо. Пишите: support@ana-yurt.com.
А если хотите поддержать работу материально — это можно сделать здесь: ko-fi.com/anayurt. Эта поддержка превращается в новые записи живой речи — а записывать её важно сейчас, пока есть у кого учиться.